Pontos-chave
- A AIoT transforma o ecrã de um dispositivo de saída passivo numa ferramenta ativa de visualização de inferência — o que requer renderização acelerada por GPU, reconfiguração dinâmica da interface do utilizador e apresentação probabilística de dados, funcionalidades que os painéis HMI tradicionais não conseguem suportar.
- Os nós periféricos com vários ecrãs (um motor de inferência a controlar 2 a 3 ecrãs) colocam desafios em termos de multiplexação e sincronização da interface. Uma caixa selada com dois painéis e um módulo de IA periférico atingiu 68 °C no interior em 45 minutos nos nossos testes — o arrefecimento ativo torna-se imprescindível.
- Os modos de ecrã sempre ativo passam de um “extra” para um requisito de segurança nos sistemas AIoT. As arquiteturas híbridas (um pequeno ecrã OLED sempre ativo + um ecrã TFT maior que se ativa em caso de alerta) oferecem a melhor relação entre consumo de energia e visibilidade para aplicações médicas e de segurança industrial.
- O pipeline de visualização acrescenta 11–37 ms de latência (gravação no buffer de imagens + processamento do controlador + tempo de resposta do ecrã). No caso dos sistemas de segurança de robôs colaborativos, isto pode significar a diferença entre apresentar uma trajetória de movimento precisa e uma que já está desatualizada.
- Ao selecionar ecrãs para produtos AIoT, inclua quatro perguntas na sua lista de verificação de especificações: latência máxima aceitável do pipeline, capacidade de controlo de vários ecrãs, requisitos do modo «sempre ligado» e orçamento térmico total do sistema.
Índice
- Do painel passivo ao ecrã de inferência ativa
- Alteração do requisito 1: Renderização de inferência dinâmica
- Alteração de requisito 2: Nós periféricos com vários ecrãs
- Mudança no requisito 3: o funcionamento contínuo passa a ser a norma
- Alteração do requisito 4: O orçamento de latência do ecrã
- O que isto significa para o abastecimento de ecrãs
- Perguntas Frequentes (FAQ)
- Referências e leituras complementares
O termo “AIoT” — a convergência entre a inteligência artificial e a Internet das Coisas — tem sido uma palavra-chave em feiras de comércio há anos. Na electronicAsia 2025, em Hong Kong, a nossa equipa demonstrou um protótipo de placa-mãe AIoT que controlava várias saídas de ecrã com inferência de redes neurais integrada no próprio dispositivo. As conversas que se seguiram — com engenheiros de mais de 20 países ao longo de quatro dias — confirmaram algo que eu vinha a observar nos nossos projetos de integração: os requisitos para os ecrãs industriais estão a mudar porque os sistemas aos quais se ligam estão a sofrer alterações fundamentais.
Este artigo documenta quatro formas específicas como a AIoT está a redefinir os requisitos dos ecrãs, com base no que ouvimos dos engenheiros no terreno, no que observámos nos nossos próprios projetos de integração desde a electronicAsia e nas implicações de engenharia para as equipas de hardware responsáveis pela especificação dos ecrãs atualmente.
Do painel passivo ao ecrã de inferência ativa
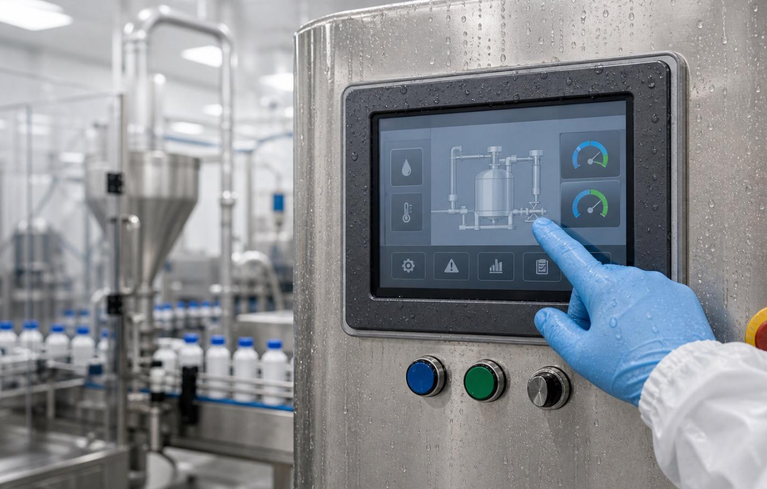
As IHM industriais tradicionais seguem um padrão previsível: o PLC transmite os valores dos sensores, o ecrã apresenta-os em widgets predefinidos (indicadores, leituras numéricas, linhas de tendência) e o operador monitoriza a ocorrência de anomalias. O ecrã é um dispositivo de saída passivo. A sua função é mostrar o que o PLC lhe diz para mostrar.
A AIoT altera esta situação de forma fundamental. Quando um motor de inferência de ponta está a funcionar no mesmo sistema — analisando espectros de vibração para a previsão de falhas nos rolamentos, monitorizando o consumo de corrente para avaliar o estado do motor ou processando imagens de câmaras térmicas para a deteção de pontos quentes —, o papel do ecrã passa de passivo para ativo. Tem de realizar tarefas para as quais os painéis HMI tradicionais nunca foram concebidos:
- Apresentar os resultados da inferência em tempo real como sobreposições em fluxos de dados em tempo real (por exemplo, um mapa de calor da probabilidade de falha prevista sobreposto a uma imagem térmica em tempo real)
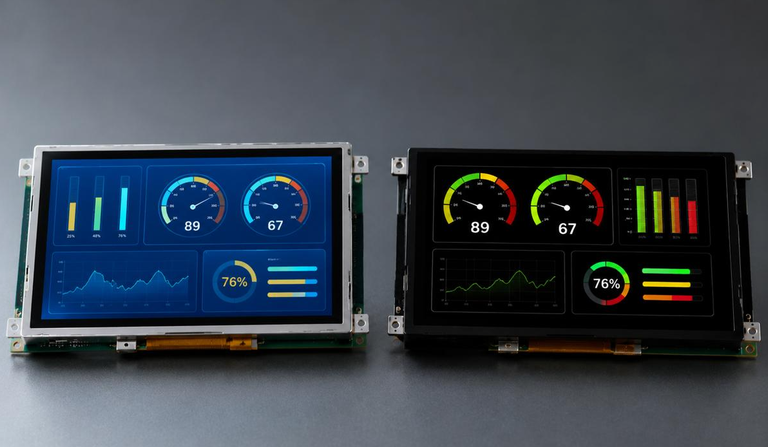
- Suportar a reconfiguração dinâmica da interface do utilizador com base nos níveis de confiança do modelo de IA (uma previsão com baixa confiança ativa uma visualização de diagnóstico mais detalhada; um alerta crítico com elevada confiança ativa um aviso em ecrã inteiro)
- Mostrar resultados probabilísticos — intervalos de confiança, faixas de incerteza, distribuições de probabilidade — que exigem uma codificação visual fundamentalmente diferente da das leituras determinísticas dos sensores (“temperatura: 72,3 °C”)
Isto tem implicações diretas para o controlador do ecrã e para a interface entre o processador e o painel.
Alteração do requisito 1: Renderização de inferência dinâmica
A renderização de sobreposições probabilísticas a 60 fps requer aceleração por GPU e uma interface de visualização com elevada largura de banda. Os painéis baseados em SPI — ainda comuns em IHMs de baixo custo — simplesmente não conseguem acompanhar o ritmo.
A questão não se resume apenas à largura de banda. Tem a ver com a natureza do pipeline de renderização. Quando se sobrepõe um mapa de calor de inferência translúcido a uma transmissão de vídeo em direto, a GPU precisa de compor dois framebuffers (o fotograma de vídeo e a sobreposição do mapa de calor) com mistura alfa e, em seguida, enviar o resultado para o ecrã. A sobrecarga de comandos por pixel da SPI acrescenta latência em cada etapa. O modo de vídeo baseado em pacotes da MIPI DSI transmite o fotograma composto diretamente para o controlador do ecrã, sem intervenção por pixel do processador anfitrião.
| Tarefa de renderização | SPI (50 MHz) | MIPI DSI (4 vias) |
| Painel de instrumentos estático | ✅ | ✅ |
| Sobreposição de gráficos de dados em tempo real | ❌ (lágrimas) | ✅ |
| Mapa de calor de inferência com mistura alfa | ❌ | ✅ |
| Reconfiguração dinâmica da interface do utilizador a 60 fps | ❌ | ✅ |
Nos nossos testes com um sistema de demonstração de manutenção preditiva (4.º trimestre de 2025), a mudança de um painel baseado em SPI para um painel baseado em MIPI eliminou o efeito de “tearing” visível e reduziu a latência de renderização de ponta a ponta, desde “inferência concluída” até «pixel atualizado», em aproximadamente 18 ms — passando de cerca de 35 ms para cerca de 17 ms. No caso de um alerta de manutenção, esta diferença é insignificante. No caso de um alerta crítico para a segurança num robô colaborativo, é significativa.
Alteração de requisito 2: Nós periféricos com vários ecrãs
Um único nó de borda AIoT serve frequentemente vários terminais de visualização. Considere uma estação de controlo de qualidade de uma fábrica inteligente que ajudámos a conceber no início de 2026:
- Ecrã 1 (principal): Ecrã TFT de 10,1 polegadas, 1280×800, apresentando a interface principal de inspeção com imagens de peças fabricadas anotadas por IA
- Ecrã 2 (secundário): Ecrã TFT de 4,3 polegadas, 480×272, que apresenta métricas de estado do sistema, taxa de processamento de inferência (fotogramas/segundo) e fila de alertas
- Ecrã 3 (terciário): Ecrã TFT de 2,1 polegadas, 480×480, montado diretamente na correia transportadora, que indica ao operador da linha o estado de aprovação/reprovação
Os três ecrãs são controlados por um único módulo de computação de ponta (Rockchip RK3588) que executa a tarefa de inferência — um modelo TensorFlow Lite que realiza a deteção de defeitos em tempo real a 30 fps.
Esta arquitetura cria desafios que os sistemas com um único ecrã não enfrentam:
Multiplexação de interfaces
O RK3588 dispõe, de forma nativa, de uma saída MIPI DSI de 4 vias e de uma saída HDMI. Para ligar três ecrãs, é necessário:
- MIPI DSI → Ecrã 1 (principal, 10,1 polegadas)
- Conversão HDMI → LVDS → Ecrã 2 (secundário, 4,3 polegadas)
- MIPI CSI (reconfigurado como saída de ecrã) → Ecrã 3 (terciário, 2,1 polegadas)
A conversão da interface para o Ecrã 2 adicionou o $8.50 à lista de materiais (BOM) e exigiu um projeto personalizado da placa de circuito impresso (PCB). Este é o tipo de custo que surpreende as equipas que partem do princípio de que “o processador pode controlar vários ecrãs” sem verificar a disponibilidade real da interface.
Sincronização
Se o Ecrã 1 mostrar uma imagem de uma peça anotada por IA e o Ecrã 3 mostrar o indicador de aprovação/reprovação correspondente, estes devem permanecer sincronizados com uma precisão de um fotograma (~16,7 ms a 60 Hz). Caso contrário, o operador vê um indicador de “aprovado” no Ecrã 3 enquanto o Ecrã 1 ainda mostra uma peça não inspecionada — ou pior ainda, uma peça marcada como “reprovada” enquanto a imagem não apresenta qualquer defeito.
A nossa solução: um mecanismo de sincronização de framebuffer partilhado, em que o resultado da inferência é gravado numa região de memória partilhada da qual ambos os pipelines de visualização leem, com um mecanismo de bloqueio baseado em carimbos de data e hora. A implementação acrescentou aproximadamente 200 linhas de código C++ ao controlador de visualização e 2 ms de latência adicional — o que é aceitável para esta aplicação.
Gestão térmica
Este é o problema que nos apanhou de surpresa. O módulo de computação de ponta que executa a inferência gera um calor significativo. A adição de várias luzes de fundo de ecrã muito próximas agrava o problema térmico.
Nos nossos próprios testes com um invólucro estanque (IP65, sem ventilação ativa):
| Componente | Dissipação de potência |
| Módulo de IA de ponta RK3588 (a executar inferência) | ~8 W |
| Ecrã TFT de 10,1 polegadas com retroiluminação | ~3 W |
| Ecrã TFT de 4,3 polegadas com retroiluminação | ~1,5 W |
| Ecrã TFT de 2,1 polegadas com retroiluminação | ~0,8 W |
| **Total** | **~13,3 W** |
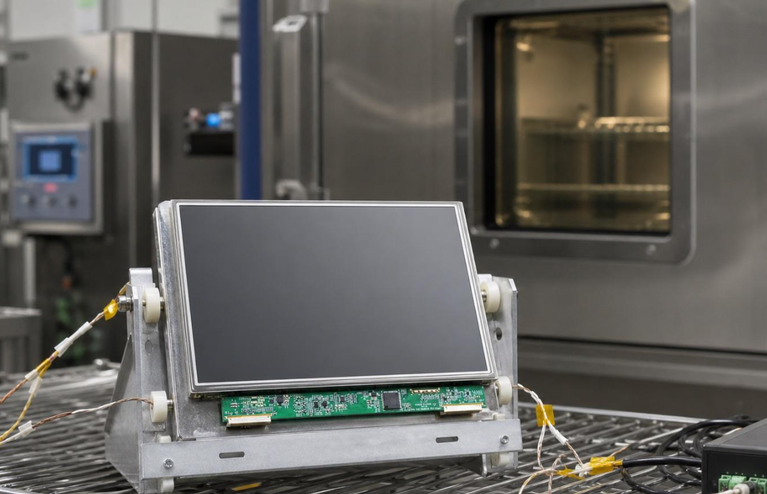
A caixa selada atingiu uma temperatura interna de 68 °C no espaço de 45 minutos. A esta temperatura, o RK3588 começou a sofrer limitação térmica (reduzindo o rendimento de inferência de 30 fps para cerca de 12 fps) e os painéis LCD apresentaram uma degradação mensurável do contraste.
A solução: um módulo de arrefecimento ativo baseado num elemento Peltier e um composto de encapsulamento termocondutor para transferir o calor dos conjuntos de LEDs de retroiluminação para a parede do invólucro. Isto acrescentou aproximadamente 1 TP4T22 à lista de materiais (BOM) e 3 W ao consumo energético (para o elemento Peltier), mas manteve a temperatura interna abaixo dos 55 °C sob carga sustentada.
Lição: Se o seu sistema AIoT controlar vários ecrãs num invólucro selado, realize simulações térmicas com todos os componentes na dissipação máxima antes finalizar o projeto mecânico. Não se deve partir do princípio de que a caixa consegue dissipar passivamente mais de 10 W sem que haja aumento de temperatura.
Mudança no requisito 3: o funcionamento contínuo passa a ser a norma
Os dispositivos IoT alimentados a bateria costumavam utilizar um sistema agressivo de gestão de energia do ecrã — escurecendo após 10 segundos e desligando-se após 30. O ecrã era o maior consumidor de energia, pelo que minimizar o seu ciclo de funcionamento era a otimização óbvia.
A AIoT muda a equação. Quando o dispositivo está continuamente a processar dados dos sensores e a fazer inferências, o estado “desligado” do ecrã cria uma lacuna perigosa: o sistema sabe alguma coisa — uma falha prevista num rolamento, uma fuga de gás detetada, um aumento anómalo da temperatura — mas o utilizador não consegue ver porque o ecrã está em modo de suspensão.
O funcionamento contínuo — pelo menos no caso de um indicador de estado ou de uma barra de alerta — torna-se um requisito de segurança, e não uma funcionalidade de conveniência.
Três abordagens que temos visto dar resultado
| Abordagem | Redução do consumo de energia do ecrã | Ideal para | Compromisso |
| **Atualização parcial do ecrã** (atualização apenas das áreas alteradas) | Redução 30–50% | Painéis de estado com conteúdo maioritariamente estático e pequenas áreas dinâmicas | Requer um controlador de ecrã com suporte para atualizações parciais (nem todos os controladores têm esta funcionalidade) |
| **Modo de espera de baixo consumo com profundidade de cor reduzida** (8 cores ou monocromático) | Redução 60–80% | Indicadores de alerta que devem mostrar o estado crítico à primeira vista | Densidade de informação limitada no modo de espera — não é possível apresentar dados detalhados |
| **Arquitetura híbrida:** um pequeno ecrã OLED sempre ligado (1,3 polegadas) + um ecrã TFT maior que se ativa em caso de alerta ou ao toque | Redução de ~90% para o TFT primário | Dispositivos médicos e sistemas de segurança industrial sujeitos a requisitos regulamentares de funcionamento contínuo | Custo adicional da lista de materiais (BOM) (~$12–18 para o sub-ecrã OLED e o controlador), complexidade mecânica |
A abordagem híbrida tem vindo a ganhar mais popularidade no domínio dos dispositivos médicos, onde os requisitos regulamentares (IEC 60601-1-8 para sistemas de alarme) exigem frequentemente uma indicação visual contínua do estado do sistema. Um pequeno ecrã OLED que exibe um ícone de batimento cardíaco, o nível da bateria e o estado do alarme consome entre 8 e 15 mW no modo sempre ligado. O ecrã TFT principal de diagnóstico só se liga quando o médico interage com ele, poupando entre 2 e 4 W de energia de retroiluminação contínua.
Alteração do requisito 4: O orçamento de latência do ecrã
Esta foi a constatação que apanhou muitos engenheiros de surpresa durante as nossas discussões sobre as demonstrações da electronicAsia 2025. Quando se desenvolve um sistema AIoT em tempo real, é necessário prever a latência em todas as fases:
- Amostragem do sensor (por exemplo, acelerómetro a 10 kHz → 0,1 ms por amostra)
- Pré-processamento de dados (FFT, filtragem → 2–5 ms)
- Inferência do modelo (passagem direta da rede neural → 5–50 ms, dependendo da complexidade do modelo)
- Acionamento ou alerta (paragem do motor, fecho da válvula, ativação do alarme → 1–10 ms)
O que muitas vezes é esquecido é o ecrã latência do pipeline — o tempo que decorre entre “o motor de inferência ter um resultado” e “o operador humano poder vê-lo”.”
Um pipeline de visualização típico inclui:
| Fase do pipeline | Latência (típica) | Notas |
| Gravação no buffer de imagens (GPU → controlador de ecrã) | 2–8 ms | Depende da resolução e da largura de banda da interface |
| Processamento do controlador de ecrã (dimensionamento, rotação, composição de sobreposições) | 1–4 ms | Depende da complexidade do controlador e do número de camadas |
| Tempo de resposta do ecrã (cinzento a cinzento) | 8–25 ms | Depende do modo LC (TN é mais rápido do que IPS) e da temperatura (fica mais lento quando está frio) |
| **Pipeline de visualização total** | **11–37 ms** | Da “decisão de exibição” ao “pixel visível” |
Quando a latência é importante
Num sistema de manutenção preditiva em que o motor de inferência deteta uma avaria iminente num rolamento e precisa de alertar o operador, 37 ms é suficiente — a degradação do rolamento ocorre ao longo de minutos a horas.
Num sistema de segurança de um robô colaborativo (cobot) em que o ecrã mostra a trajetória de movimento pretendida do robô, uma latência de 37 ms no ecrã pode significar a diferença entre o operador ver uma trajetória precisa e ver uma que já está desatualizada. Um braço de cobot que se move a 1 m/s percorre 37 mm em 37 ms — o suficiente para ficar fora da “zona de segurança” apresentada no ecrã.”
Medidas de mitigação arquitetónicas
A solução nem sempre é “comprar um painel mais rápido”. Por vezes, é uma questão de arquitetura:
- Ignorar o compositor da GPU para sobreposições críticas em termos de segurança. As gravações diretas do framebuffer, do motor de inferência para um plano de sobreposição dedicado, podem reduzir o tempo de processamento em 2 a 4 ms. Para tal, é necessário que o controlador de ecrã suporte vários planos de sobreposição de hardware.
- Utilize painéis com modos LC mais rápidos. Os painéis TN têm uma resposta mais rápida do que os IPS (normalmente 5–10 ms de cinzento a cinzento, contra 12–25 ms), embora à custa dos ângulos de visão. Algumas variantes IPS mais recentes (S-IPS, AH-IPS com overdrive) atingem 10–12 ms. Especifique explicitamente o requisito de tempo de resposta.
- Dividir a exibição por classe de latência. Os indicadores críticos para a segurança (estado do alarme, estado do robô, confirmação da paragem de emergência) são atualizados à taxa de fotogramas máxima com uma latência mínima no pipeline — renderizados num plano de sobreposição de hardware dedicado. As informações contextuais (gráficos de tendências, registos de manutenção, diagnósticos do sistema) são atualizadas a 10–15 fps através do pipeline normal de composição da GPU. O utilizador visualiza as informações críticas imediatamente e as informações contextuais pouco tempo depois.
O que isto significa para Ecrã Aprovisionamento
Se a sua equipa estiver a desenvolver um produto de IAoT, as especificações do ecrã têm de ir além da lista tradicional de critérios, como tamanho, resolução, brilho e interface. Acrescente estas quatro perguntas:
1. Qual é a latência máxima aceitável do pipeline de visualização para informações críticas para a segurança?
Isto determina a escolha do painel (TN vs. IPS, especificações do tempo de resposta), a arquitetura da interface (modo de vídeo MIPI vs. modo de comando) e a decisão sobre a implementação de planos de sobreposição de hardware dedicados para indicadores críticos.
2. De quantos ecrãs necessita o sistema e o processador principal consegue controlá-los de forma nativa?
Se o processador tiver apenas uma saída de ecrã e precisar de três ecrãs, preveja desde cedo os custos com a conversão de interfaces ou a divisão de ecrãs — e não depois de o layout da placa de circuito impresso estar concluído. A conversão de interfaces aumenta o custo da lista de materiais ($5–15 por ecrã adicional) e acrescenta 2–4 ms de latência por etapa de conversão.
3. O ecrã necessita de um modo «sempre ligado» por razões de segurança ou por motivos regulamentares?
Se sim, avalie controladores de ecrã com capacidade de atualização parcial (poupa 30–50% de energia em comparação com a atualização completa) e considere arquiteturas de ecrã híbridas (um pequeno ecrã OLED sempre ligado + um ecrã TFT maior que se ativa apenas quando necessário). Especifique explicitamente o consumo energético do ecrã sempre ligado.
4. Qual é o balanço térmico total do sistema, incluindo todas as luzes de fundo dos ecrãs na luminosidade máxima?
Realizar simulações térmicas com todos os componentes na dissipação máxima antes finalizar o projeto da caixa. Uma caixa selada com classificação IP65 e 13 W de dissipação interna atingirá 65–70 °C no espaço de uma hora sem refrigeração ativa. Tenha em conta a solução de refrigeração na lista de materiais (BOM) e no orçamento de potência desde o início.
Perguntas Frequentes (FAQ)
P1: Posso utilizar um painel HMI industrial padrão numa aplicação de AIoT?
Depende do que o modelo de IA produzir. Se o resultado da inferência for um simples valor escalar (por exemplo, “estado do rolamento: 87%”) que corresponde a um indicador padrão, um painel HMI tradicional poderá ser suficiente. Se a inferência produzir resultados probabilísticos, mapas de calor, caixas delimitadoras ou reconfiguração dinâmica da interface do utilizador, será necessário um painel com renderização acelerada por GPU e uma interface de elevada largura de banda (MIPI DSI ou LVDS). Os painéis HMI padrão com interfaces SPI e controladores de ecrã básicos irão criar um estrangulamento no pipeline de renderização.
P2: Como é que escolho entre executar a inferência no dispositivo periférico ou na nuvem?
A inferência na periferia (no próprio dispositivo) elimina a latência da rede e funciona sem conectividade, mas está limitada pela capacidade computacional do processador de periferia. A inferência na nuvem pode executar modelos maiores e mais precisos, mas introduz uma latência de ida e volta na rede de 50–200 ms. Para atualizações de ecrã críticas para a segurança (alarmes, estado do robô), a inferência na periferia é claramente preferível, uma vez que o pipeline de visualização já acrescenta 11–37 ms — adicionar 50–200 ms de latência na nuvem a isso resulta num total inaceitável. Para análises não críticas e visualização de tendências, a inferência na nuvem é adequada.
P3: Qual é o tamanho mínimo do ecrã para um indicador de estado sempre ativo?
Para um ícone simples + indicação numérica (por exemplo, símbolo de batimento cardíaco + “72 BPM”), um ecrã OLED de 1,0 a 1,5 polegadas é suficiente. Para uma barra de alerta com texto (por exemplo, “BEARING 3: ALTA VIBRAÇÃO”), 2,0–2,4 polegadas é o mínimo necessário para que o texto seja legível à distância de um braço. O módulo OLED mais pequeno da QIHAN com capacidade de funcionamento contínuo tem 0,96 polegadas (128×64), sendo adequado para indicação de estado apenas com ícones.
P4: A QIHAN pode fornecer o módulo de computação incorporado, bem como o ecrã?
Sim. Para aplicações de AIoT, oferecemos soluções integradas que incluem o painel de visualização, o painel tátil, a colagem ótica, o módulo de computação incorporado (plataformas Rockchip ou NXP) e a conversão de interfaces, conforme necessário. Encargamo-nos da integração do controlador de visualização ao nível do BSP. A vossa equipa encarrega-se do software da camada de aplicação e da implementação do modelo de IA.
P5: Como posso testar a latência de ponta a ponta do meu pipeline de visualização?
O método mais prático: ligar uma câmara de alta velocidade (240+ fps) apontada tanto para o ecrã como para um LED acionado por GPIO. Quando o motor de inferência produz um resultado, acende e apaga o LED e apresenta o resultado no ecrã. A câmara capta ambos os eventos. Conte os fotogramas entre a alteração do LED e a atualização do ecrã — cada fotograma a 240 fps = 4,17 ms. Isto permite-lhe obter uma medição empírica da latência de ponta a ponta sem necessidade de instrumentar o pipeline de software.
P6: Que soluções térmicas recomendam para sistemas AIoT com vários ecrãs em caixas seladas?
Por ordem crescente de custo e complexidade: (1) almofadas isolantes termicamente condutoras entre as placas de circuito impresso (PCB) da retroiluminação e as paredes do invólucro (passivas, ~$2–5 BOM), (2) invólucro de alumínio com aletas de dissipação de calor integradas (passivo, aumenta o custo do invólucro), (3) módulo de arrefecimento termoelétrico Peltier com dissipador de calor externo (ativo, ~$15–25 BOM, acrescenta um consumo de energia de 2–5 W), (4) arrefecimento por ar forçado com entrada/saída filtradas (ativo, compromete a classificação IP). Para caixas seladas com classificação IP65+ e dissipação interna superior a 10 W, são normalmente necessárias as opções 2 ou 3.
P7: A QIHAN disponibiliza ecrãs com capacidade de atualização parcial?
Sim. Vários dos nossos módulos TFT suportam a atualização parcial no modo de comando através do MIPI DSI, permitindo que apenas as áreas alteradas do ecrã sejam atualizadas. Isto pode reduzir o consumo de energia do ecrã em 30–50% em cenários de ecrã sempre ligado, em que a maior parte do conteúdo do ecrã é estático. Contacte a nossa equipa de engenharia com os seus requisitos específicos de ecrã sempre ligado — a abordagem correta depende das informações que precisam de permanecer visíveis de forma contínua.
Sobre a QIHAN
Shanghai Qihan Technology Co., Ltd. (QIHAN) é um fabricante e fornecedor de soluções personalizadas de ecrãs de pequenas e médias dimensões, especializado em ecrãs TFT LCD, OLED, LCM, ecrãs táteis e módulos de ecrã personalizados para aplicações industriais, médicas, automóveis, de casa inteligente e de eletrónica de consumo. Com mais de 15 anos de experiência em I&D e uma capacidade de produção diária de 30 000 LCMs, a QIHAN presta serviços OEM/ODM, desde a conceção até à produção em série.
 English
 Português
 Français
 Deutsch
 Español
 Русский